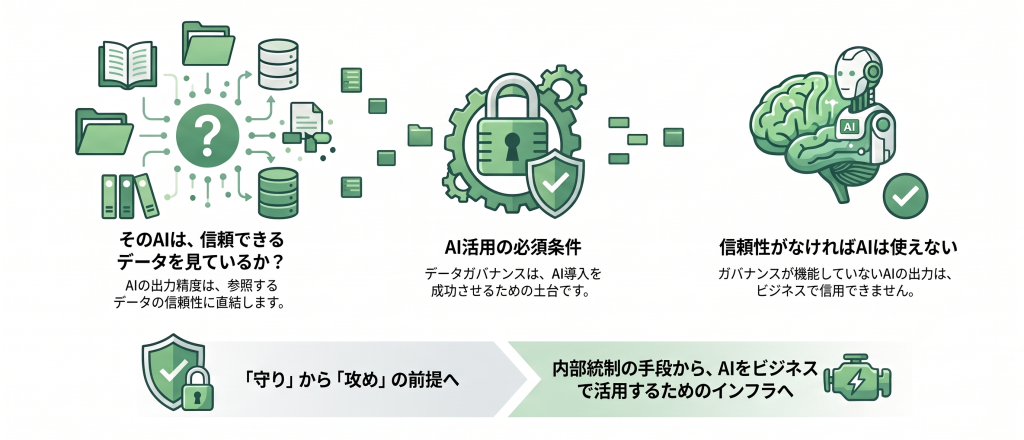
生成AIやAIエージェントの業務適用が進むなかで、これまでとは違う問いが投げかけられるようになりました。「そのAIは、信頼できるデータを見ているのか」という問いです。
データガバナンスという言葉自体は、決して新しいものではありません。これまでは主に、法規制への対応や内部統制といったコンプライアンス文脈で語られてきました。ところがAIの活用が広がるにつれ、位置づけが変わりつつあります。AIが参照するデータの信頼性が担保されていなければ、AIの出力そのものが信用できない——つまり、ガバナンスは守りの取り組みであると同時に、AI活用の前提条件になったわけです。
本記事では、データガバナンスの定義と構成要素を整理したうえで、「ルールを作ったのに回らない」という現場の課題、AI時代に新たに求められる論点、そして現実的な進め方までを解説します。
この記事で分かること
- データガバナンスの定義と、押さえるべき5つの構成要素
- ガバナンスのルールが現場で回らなくなる、3つの原因
- AI時代に求められる新しい論点と、現実的な進め方の5ステップ
1. データガバナンスとは
定義
データガバナンスとは、組織が保有するデータを資産として管理し、その品質・安全性・活用可能性を継続的に担保するための仕組みとルールを指します。
ポイントは「継続的に」という部分です。一度きりのデータ整備プロジェクトではなく、日々変化していくデータに対して、決めた基準が守られ続ける状態をつくることが目的になります。そのため、ルールの策定だけでなく、それを回すための体制や仕組みまでが含まれます。
データマネジメントとの違い
よく混同されるのが「データマネジメント」です。両者の関係は、役割の階層で整理すると分かりやすくなります。
データガバナンスは「方針・統制」の層です。どのようなルールでデータを扱うのか、誰が責任を持つのか、何をもって品質が担保されたとみなすのか。こうした決めごとと、それが守られているかを監督する機能を担います。
データマネジメントは「実務・運用」の層です。実際にデータを統合し、クレンジングし、カタログ化し、アクセス権を設定する。決められた方針を、日々の作業として実行する部分にあたります。
ガバナンスなきマネジメントは、担当者ごとにやり方が異なる属人的な運用になりがちです。逆に、マネジメントの裏づけがないガバナンスは、文書だけが存在して実態が伴わない状態を招きます。両輪で考える必要があります。
なぜ必要なのか
データガバナンスが求められる理由は、大きく3つあります。
ひとつは、意思決定の信頼性です。経営判断の根拠となる数値が部署によって食い違っていたり、いつの時点のデータか分からなかったりすれば、判断そのものが揺らぎます。
ふたつ目は、法規制への対応です。個人情報保護法をはじめとする各種規制は、データの取得・保管・利用について適切な管理を求めています。どこにどんなデータがあるかを把握できていなければ、対応のしようがありません。
そして三つ目が、AI活用の前提としての役割です。ここが、従来のガバナンス論と大きく異なる点になります。
2. データガバナンスの主な構成要素
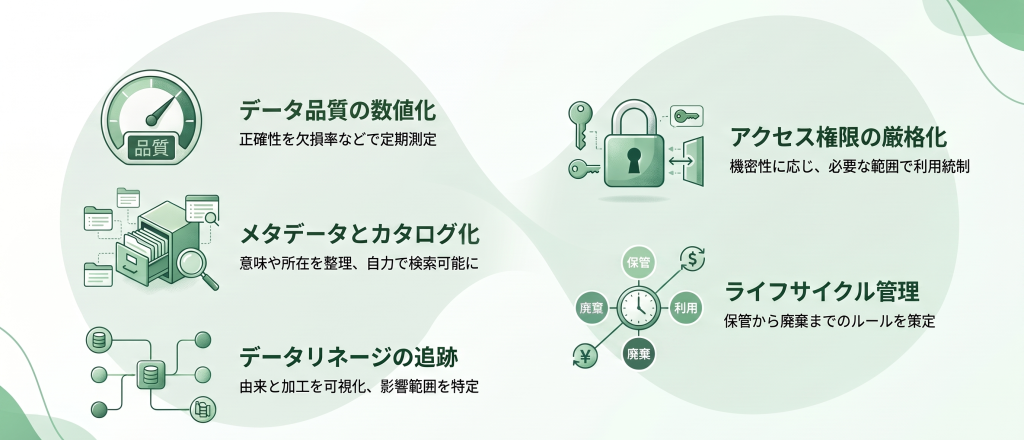
データガバナンスは幅広い概念ですが、実務上は次の5つの要素に整理できます。
データ品質
最も中核となる要素です。「品質が高いデータ」とは何かを具体的に定義し、測定できる状態にすることが求められます。
一般的には、次のような観点で評価します。正確性(実態と一致しているか)、完全性(必要な項目が欠けていないか)、一貫性(システム間で矛盾がないか)、鮮度(いつ時点のデータか)、そして一意性(重複がないか)。
重要なのは、これらを感覚ではなく数値で測ることです。「だいたい整っている」という認識では、改善したかどうかも判断できません。欠損率やエラー件数といった指標を定め、定期的に測定する仕組みが要ります。
メタデータ管理・データカタログ
データそのものではなく、「データについての情報」を管理する要素です。テーブルや項目が何を意味するのか、誰が管理しているのか、いつ更新されたのか、といった情報を指します。
これを組織全体で検索できる形に整理したものが、データカタログです。「売上データはどこにあるか」「この項目の定義は何か」を担当者が自力で探せる状態をつくります。データカタログが整備されていないと、データを探すこと自体に時間がかかり、結果として同じようなデータが各部署で重複して作られていく、という事態を招きます。
データリネージ
データがどこから来て、どのような加工を経て、いまの形になったのかを追跡できる状態を指します。系統や来歴と訳されることもあります。
ある数値が誤っていたとき、どの段階で問題が生じたのかを遡れるかどうか。あるいは、あるデータソースを変更したとき、どのレポートに影響が及ぶのかを事前に把握できるかどうか。リネージが整っていれば、こうした調査や影響範囲の特定が可能になります。
アクセス管理・権限統制
誰がどのデータにアクセスできるのかを管理する要素です。機密情報や個人情報を扱う以上、必要な人だけが必要な範囲で参照できる状態が前提になります。
AI活用の文脈では、この要素の重要性がさらに高まります。AIが社内データへアクセスする際も、利用するユーザー本人の権限の範囲内で動作する必要があるためです。この仕組みについては、別記事「AIに社内のデータ・システムを安全につなぐには?MCPの仕組みと選び方」で解説しています。
ライフサイクル管理
データの一生を管理する要素です。いつまで保管するのか、どの時点でアーカイブへ移すのか、廃棄の基準と手順はどうするのか、といったルールを定めます。
法規制で保管期間が定められているデータもあれば、逆に不要になったら速やかに削除すべきデータもあります。何も決めずにすべてを保持し続けると、ストレージコストが膨らむだけでなく、古い情報が現役のデータと混在してAIの誤回答を招く原因にもなります。
3. なぜ「ルールを作ったのに回らない」のか
データガバナンスに取り組む企業の多くが、同じ壁に突き当たります。方針は策定した。ガイドラインも整備した。データオーナーも任命した。それなのに、現場の運用に落ちていない——という状態です。
原因は、大きく3つに整理できます。
原因①:データが分断・散在しており、全体を把握できない
ガバナンスの出発点は、どこにどんなデータがあるかを把握することです。ところが実際には、基幹システム、部門ごとのデータベース、ファイルサーバー、各種SaaS、そして個人のExcelファイルにまでデータが散らばっています。
全体像が見えないまま「データを適切に管理しましょう」というルールだけを作っても、何を管理対象とするのかが定まりません。結果として、把握できている一部のデータにしかルールが適用されない、という事態になります。
原因②:品質チェックが手作業・属人的で、継続できない
品質基準を定めても、その確認が手作業であれば、続けることは困難です。担当者がSQLを書いて欠損値を数え、Excelで重複をチェックする。こうした運用は、データ量が増えるほど、対象システムが増えるほど破綻していきます。
そして、担当者が異動や退職でいなくなれば、その仕組みごと失われます。「前任者がやっていた確認作業が、いつの間にか止まっていた」という話は珍しくありません。
原因③:ルールが守られているかを可視化・測定する手段がない
三つ目が、最も根本的な問題かもしれません。決めたルールが実際に守られているのか、データの品質はいま何点なのか、前月と比べて改善しているのか。これらを客観的に示す手段がなければ、ガバナンスは「やっているつもり」から抜け出せません。
測定できないものは改善もできません。経営層に対して取り組みの成果を説明することもできず、結果として投資の継続が難しくなる、という悪循環に陥ります。
これら3つの原因に共通するのは、いずれも「仕組み」の問題だという点です。
体制や意識の問題として語られがちですが、実際にはデータが統合されていないこと、確認作業が自動化されていないこと、測定の仕組みがないことに起因しています。文書としてのガバナンスだけが残り、データの信頼性は上がらない——多くの現場で起きているのは、この状態です。
4. AI時代に求められる新しい論点
ここまでは、従来から語られてきたデータガバナンスの話です。AIの活用が進むいま、これに新しい論点が加わっています。
「人が気づく」という前提が失われる
従来のデータ活用では、人がレポートやダッシュボードを見て判断していました。この形であれば、数値に違和感があれば担当者が気づけます。「先月と比べて明らかにおかしい」「この数字は実感と合わない」という感覚が、最後の砦として機能していたわけです。
ところがAIがデータを直接参照し、自律的に判断・実行する形になると、この前提が崩れます。誤ったデータに基づく判断が、人の目を経ずにそのまま実行結果へ反映されてしまうためです。しかもAIの出力は流暢で説得力があるため、誤りに気づくことはかえって難しくなります。
AIが自ら計画を立てて動くエージェンティックAIでは、この影響がさらに大きくなります。詳しくは別記事「エージェンティックAI(AIエージェント)とは?業務活用の実像と、動くAIに欠かせないデータ基盤」をご覧ください。
「AI-readyなデータ」という考え方
こうした背景から生まれたのが、AI-readyなデータという概念です。AIに渡して問題のない状態に整えられたデータ、という意味になります。
具体的には、次の4つの条件を満たす状態を指します。
- 統合されている:必要な情報が散在しておらず、AIが横断的に参照できる
- 品質が測定されている:正確性や鮮度が数値として把握され、基準を満たしている
- 出所を追跡できる:どのデータに基づく回答なのかを、後から検証できる
- 権限が統制されている:AIが参照できる範囲が、利用者の権限に応じて制御されている
従来のガバナンスが「人が正しく使えるように整える」ことを目的としていたのに対し、AI-readyという考え方は「AIが正しく使えるように整える」ことを目的としています。求められる水準は、むしろ厳しくなっていると言えます。
AIに渡す前に、データの信頼性を評価する
実務上の変化として重要なのが、評価のタイミングです。
従来は、出てきた結果を見てから「このデータは使えるか」を判断していました。AI活用では、渡す前に評価しておく必要があります。品質の低いデータをAIに参照させてしまえば、その時点で誤った出力が生まれ、それが業務プロセスに流れ込んでしまうためです。
AIの回答が事実と異なる「ハルシネーション」をデータ側から抑える考え方は別記事「生成AIのハルシネーションはなぜ起きる?“データ側”からの対策を解説」で、検索対象データの品質が回答精度を左右する仕組みは「社内データを生成AIで活かす「RAG」とは?精度を左右するのはデータ品質」で、それぞれ詳しく解説しています。
非構造化データもガバナンスの対象になる
もうひとつの変化が、対象範囲の拡大です。
従来のデータガバナンスは、データベースに格納された構造化データが中心でした。しかしAIは、PDFのマニュアル、Word形式の規程、議事録、メール本文といった非構造化データも参照します。
こうした文書群には、古い版が残っていたり、内容が矛盾していたり、そもそも誰が管理しているのか不明だったりするものが少なくありません。AIがそれらを参照して回答すれば、当然ながら誤った内容が返ってきます。構造化データと同じ水準で、非構造化データも管理対象に含めることが求められます。
5. データガバナンスの進め方|現実的なステップ
では、何から着手すればよいのか。現実的な進め方を5つのステップに整理します。
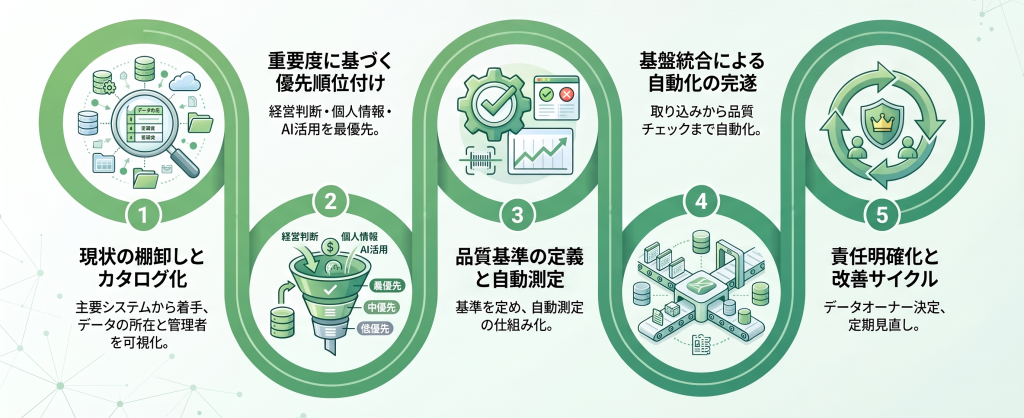
ステップ1:現状把握とカタログ化
出発点は棚卸しです。どこに、どんなデータが、どのような形式で存在しているのか。誰が管理しているのか。どのシステムから参照されているのか。これらを洗い出し、カタログとして整理します。
いきなり全社を対象にすると終わらないため、まずは主要な業務システムと、データ活用の対象になっているデータから着手するのが現実的です。
ステップ2:優先順位付け
すべてのデータを同じ水準で管理する必要はありません。重要度に応じて優先順位をつけます。
判断基準としては、経営判断に使われるデータ、個人情報や機密情報を含むデータ、そしてAI活用の対象になるデータ、といった観点が挙げられます。ここから着手することで、限られたリソースで効果を出しやすくなります。
ステップ3:品質基準の定義と測定
対象を絞ったら、そのデータについて「何をもって使える状態とするか」を定義します。欠損率は何%以下か、更新頻度はどれくらいか、重複はどこまで許容するか。
そして、定めた基準を継続的に測定する仕組みを用意します。ここを手作業にすると、原因②で述べたとおり続きません。測定は自動化することを前提に設計します。
ステップ4:統合と自動化
品質チェックを自動で回すには、その土台としてデータが統合されている必要があります。散在したままでは、システムごとに個別の確認をすることになり、結局は属人的な運用に戻ってしまいます。
データ統合基盤の上で、取り込みから品質チェックまでを一連の流れとして自動化する。これが、ガバナンスを継続させるための現実的な解になります。
ステップ5:体制・役割の整備
最後に、運用を支える体制です。データオーナー(そのデータに責任を持つ人)を明確にし、品質に問題が見つかったときに誰が対応するのかを決めておきます。
あわせて、定期的な見直しのサイクルも設計します。事業の変化に伴って、重要なデータも、求められる品質水準も変わっていくためです。ガバナンスは一度作って終わりではなく、育てていくものだと捉えるのが適切です。
6. Qlikによる解決|データ品質を評価・可視化できる基盤
ここまで述べてきた課題、とくに「測定できない」「手作業では続かない」という問題は、仕組みで解決できる領域です。インサイトテクノロジーが取り扱うQlikの製品群は、この考え方に沿って構成されています。
Qlik Talend Cloud:統合と品質管理を一体で
Qlik Talend Cloudは、データ統合とデータ品質管理を一体で提供するプラットフォームです。多様なデータソースに接続してデータを統合し、そのうえで品質を評価・管理できます。
ステップ4で述べた「統合された基盤の上で品質チェックを自動化する」という進め方を、そのまま実現できる構成になっています。
Trust Score for AI:信頼性をスコアで可視化する
特徴的なのが、AI向けにデータの信頼性を評価する「Trust Score for AI」という機能です。データの有効性・完全性・鮮度といった観点を多面的に評価し、スコアとして可視化します。
これにより、「このデータはAIに渡してよい品質か」を客観的な数値で判断できるようになります。原因③で挙げた「守られているかを測定する手段がない」という問題に対する、直接的な答えのひとつです。品質の低いデータを、AIに渡す前の段階で止められる点も実務上の利点になります。
Qlik Replicate:鮮度という品質要件に応える
データ品質の要素には鮮度が含まれます。どれだけ正確でも、1日前の情報では判断を誤る場面があるためです。
Qlik Replicateは、CDC(Change Data Capture)によってデータベースの変更をリアルタイムに捉え、連携先へ反映します。エージェントレス設計のため本番DBへの負荷も小さく、鮮度を保ちながらデータを集め続けられます。
Qlikが選ばれる理由:ルール管理にとどまらない点が違い
一般的なデータガバナンスを支援するツールには、ポリシーの管理やカタログ化に主眼を置いたものもあります。それらは方針の整備には有効ですが、実際のデータそのものに手を入れる機能は持たないことが一般的です。
Qlikを軸にしたアプローチの特徴は、データ統合の実行基盤とセットで品質を担保できる点にあります。ルールを管理するだけでなく、そのルールに沿ってデータを統合し、品質を測定し、基準を満たさないものを検出するところまでを、同じ基盤の上で回せます。
まとめ
- データガバナンスとは、データを資産として管理し、品質・安全性・活用可能性を継続的に担保する仕組みとルール。方針・統制を担うガバナンスと、実務・運用を担うマネジメントは両輪の関係にある
- 構成要素は、データ品質・メタデータ管理/データカタログ・データリネージ・アクセス管理/権限統制・ライフサイクル管理の5つ
- ルールが回らない原因は、データの分断・散在、手作業による品質チェックの限界、そして遵守状況を測定する手段の不在。いずれも体制ではなく仕組みの問題
- AI時代は「人が誤りに気づく」前提が失われるため、AIに渡す前にデータの信頼性を評価する必要がある。対象には非構造化データも含まれる
- 進め方は、現状把握とカタログ化 → 優先順位付け → 品質基準の定義と測定 → 統合と自動化 → 体制・役割の整備の5ステップ
AI活用に耐えるデータ基盤を整えたい方へ
「データガバナンスに取り組みたいが、何から始めればよいか分からない」「品質チェックが手作業のままで続かない」「AIに渡すデータの信頼性をどう担保すべきか知りたい」——インサイトテクノロジーでは、データ統合・データ品質の設計から、AI活用に向けた基盤整備までを一貫してご支援しています。まずはお気軽にご相談ください。
▼ サッポロホールディングス株式会社のQlik Talend Cloud活用事例を見る
https://www.insight-tec.com/case/sapporohd_0037
▼ Qlik Talend Cloudについて詳しく見る
https://www.insight-tec.com/products/qlik-talend-cloud
▼ Qlikが実現できるデータ統合の詳細
https://www.insight-tec.com/products/qlik-data-integration-platform
▼ データガバナンス・データ基盤に関するご相談
https://www.insight-tec.com/products/qlik-talend-cloud/#f