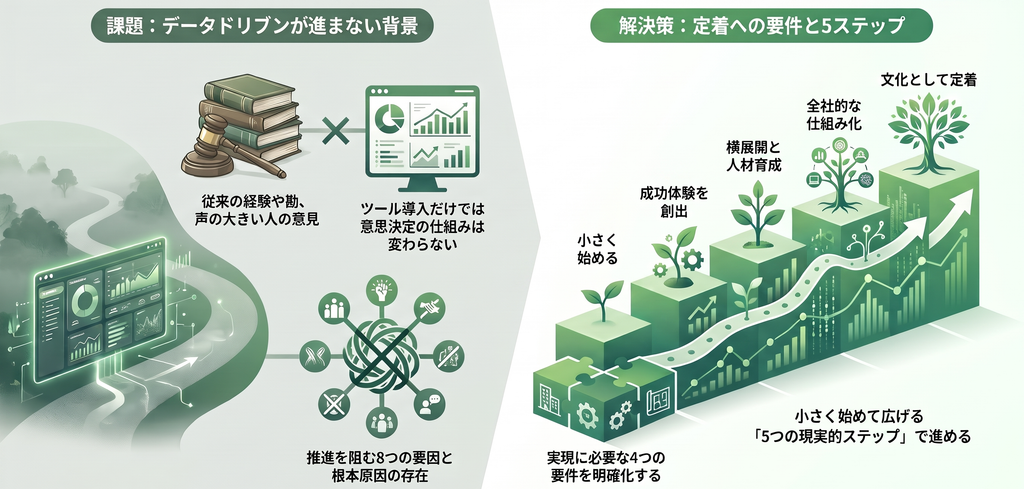
「データドリブン経営」を方針として打ち出した。BIツールも導入した。それでも、会議で出てくる判断材料は以前と変わらず、最後は声の大きい人の見立てで決まっていく——そんな状態になっていないでしょうか。
データドリブンという言葉はここ数年で一気に広まり、DXの一環としてデータ活用に取り組む企業も増えました。一方で、「データに基づいて意思決定できている」と言い切れる企業は限られます。ツールを入れても、人を採っても、組織の意思決定の仕方が変わらない。この落差には理由があります。
本記事では、データドリブンの定義とよくある誤解を整理したうえで、「掛け声だけで進まない」状態がなぜ生まれるのかを分解します。そのうえで、実現に必要な要件と、小さく始めて広げるための進め方をまとめます。
この記事で分かること
- データドリブンの定義と、BIツール導入や人材採用では進まない理由
- データドリブンが進まない8つの要因と、その根本にあるもの
- 実現に必要な4つの要件と、現実的に着手するための5つのステップ
1. データドリブンとは
定義
データドリブン(Data Driven)とは、勘や経験、前例ではなく、データに基づいて意思決定を行う考え方、およびそれが機能している組織のあり方を指します。英語の「driven(〜によって動かされる)」が示すとおり、データが判断を動かしている状態が前提です。
注意したいのは、これが「ツールの導入状態」ではなく「組織の状態」を指す言葉だという点です。ダッシュボードが存在することと、それを見て判断が変わることは別の話です。
よくある誤解①:BIツールを導入すればデータドリブンになる
もっとも多い誤解です。BIツールはデータを可視化する手段であって、可視化すべきデータが整っていなければ、見られるのは一部の範囲にとどまります。接続できないデータは可視化できず、定義が揃っていないデータを並べれば、かえって「どの数字が正しいのか」という議論が増えます。
そして、データが整っていても問題は残ります。BIツールは「何を見たいか」が決まっている人には強力ですが、「この判断をするには何を見ればよいのか」が決まっていない人に対しては、答えを出してくれません。ダッシュボードは用意されたものの、どの画面のどの数字を見れば判断できるのかが分からず、結局使われないまま残る——というのもよくある結末です。
よくある誤解②:データサイエンティストを採用すれば進む
専門人材の採用も同様です。入社した人材の時間が、分析ではなくデータの収集・加工・突合に費やされる——というのは広く見られる光景です。分析する前の「データを使える状態にする」工程が残っていれば、人を増やしてもそこがボトルネックとなります。
本質は「判断に必要な答えが得られる状態」をつくること
では何が本質なのか。ひとつは、誰もが必要なときに、信頼できるデータを参照できる状態をつくることです。特定の担当者に依頼しなければ数字が出てこない状態では、意思決定のスピードは上がりません。
ただし、参照できるだけでは足りません。データが手元にあっても、「この判断をするには何をどう見ればよいのか」が分からなければ、意思決定には至らないからです。最終的に目指すのは、行いたい意思決定に対して、適切な手法と適切な結果が得られる状態です。これまでこの部分は、データ分析の専門人材が担ってきた役割でした。後述するとおり、ここを技術で支えられるかどうかが、近年の大きな変化点になっています。
2. なぜデータドリブンが求められるのか
DX推進の文脈でデータ活用が語られる理由を整理すると、3つに集約できます。
- 意思決定のスピードと精度。市場環境の変化が速く、前例が通用しない場面が増えています。判断を早め、かつ精度を上げる必要があります
- 属人化からの脱却。担当者の勘に依存した判断は、その人が異動・退職した時点で再現できなくなります。判断の根拠がデータとして残っていれば、組織として引き継げます
- AI活用の前提。生成AIをはじめとするAI活用が広がっていますが、AIが参照するのもまたデータです。社内データが整っていなければ、AIの出力も信頼できるものにはなりません
3つ目について、AIに渡すデータをどう整えるかという論点は、別記事「データガバナンスとは?AI時代に求められる考え方と進め方」で詳しく解説しています。
3. なぜ進まないのか
「データドリブンを目指す」という方針に反対する人はほとんどいません。それでも進まないのは、現場で具体的な障害が起きているからです。データ活用の課題は、大きく2つの層に分けられます。データが使える状態になっていないという層と、そもそも何をどう見ればよいかが定まっていないという層です。
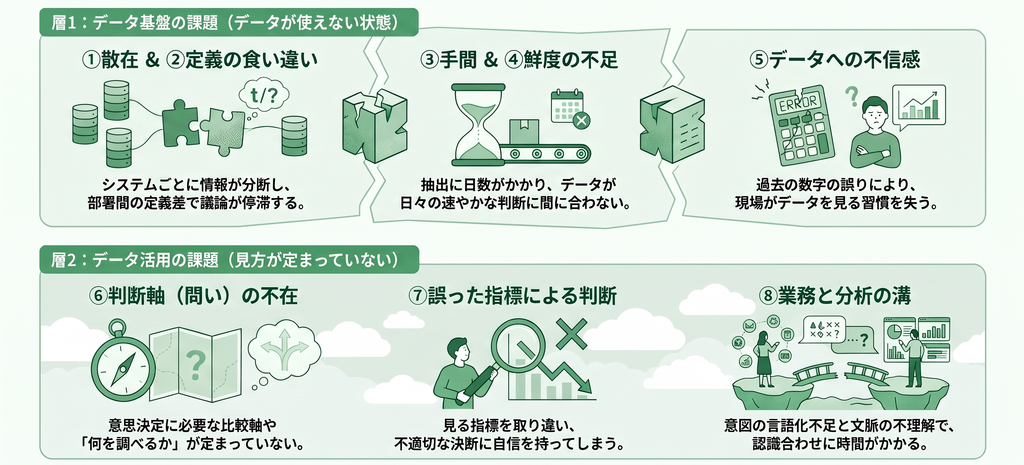
データが使える状態になっていない(5つの要因)
- 要因①:データが分断・散在している。必要な情報が基幹システム、部門ごとのデータベース、ファイルサーバー、各種SaaSに散らばり、横断して見られない。1枚の資料を作るために複数部署へ依頼が走る
- 要因②:同じ指標なのに数字が食い違う。部署ごとに算出の定義が異なり、会議が「どちらの数字が正しいのか」という議論に費やされる。判断の前段で時間が溶ける
- 要因③:データを見るまでの手間が大きい。依頼してから出てくるまでに数日かかるなら、結局その場の勘で判断したほうが早い。使われないのは、使うまでが遅いからでもある
- 要因④:データの鮮度が業務に追いつかない。昨日までの数字では、今日の判断には使えない場面がある。月次で締めた数値しかなければ、日々の判断には届かない
- 要因⑤:そもそもデータが信頼されていない。過去に誤った数字が出た経験があると、現場はデータを見なくなる。一度失われた信頼は、正しい数字を出し続けないと戻らない
何をどう見ればよいかが定まっていない(3つの要因)
データ側の問題がすべて解消しても、それだけでデータドリブンになるわけではありません。ここが見落とされやすい部分です。
- 要因⑥:何を見れば意思決定できるのかが決まっていない。売上が落ちている原因を知りたいとき、どの切り口で何と比較すれば答えに近づくのか。この問いの立て方が決まっていないと、データがあっても手が止まる
- 要因⑦:間違った指標を見て、間違った判断をする。見るべき指標を取り違えたまま分析すれば、それらしい結論が出てしまう。データに基づいている分だけ、誤った判断に自信がついてしまうこともある
- 要因⑧:ビジネス側と分析担当のやりとりに時間がかかる。業務側は「何を知りたいか」を言語化しきれず、分析担当は業務の文脈を完全には把握していない。認識をすり合わせる往復に時間がかかり、出てきた結果が求めていたものと違う、というやり直しも起きる
①〜⑤はデータ基盤の問題であり、⑥〜⑧は「データをどう使うか」の問題です。前者だけを解いても、業務側は分析担当への依頼に戻ってしまいます。データドリブンが組織に根づかない理由は、この2つが同時に残っているためです。
4. 通常の対応とその限界
こうしたデータ活用の課題に対して取られる一般的な対応としては、おおむね3つに分かれます。
- 対応①:BIツールを導入する。可視化の手段は手に入りますが、接続できるデータと定義が揃っていなければ、見られるのは一部にとどまります。結局Excelに書き出して加工する運用が残ります。また、データが揃っていても「何を見れば判断できるのか」が決まっていなければ、作られたダッシュボードは使われないまま残ります
- 対応②:データ分析人材を採用する。前述のとおり、採用した人材の時間がデータ整備に費やされます。また、業務側からの依頼が一箇所に集中し、順番待ちの行列ができます
- 対応③:全社データ基盤を構築する。正攻法ですが、全社を対象にすると大規模プロジェクト化します。要件定義に時間がかかり、成果が見える前に推進力が落ちる、というパターンに陥りやすくなります
共通する問題は、いずれも「使う側」の環境整備に注力している点です。ツールを用意し、人を配置し、器を作る。しかし、そこに流れ込む「使われるデータ」そのものの状態と、「どう使えば判断に至るのか」という部分には手が届いていません。
5. データドリブンを実現するための4つの要件
整理すると、必要な要件は4つです。
- 要件①:統合されていること。散在したデータを横断的に参照できる状態。どの基盤に集めるかという選択も含みます。クラウドデータ基盤の選び方は、本シリーズの後続記事で扱います
- 要件②:意味が定義されていること。指標の定義が組織で共有され、人もAIも同じ意味でデータを参照できる状態。この仕組み(セマンティックレイヤー)については、本シリーズの後続記事で詳しく扱います
- 要件③:品質が担保されていること。正確性と鮮度が測定され、信頼できると言える状態。品質が可視化されていなければ、現場はデータを信用しません
- 要件④:誰でも使えること。専門知識がなくても、必要なときに自分で参照し、答えを得られる状態。ここには「操作できる」だけでなく「問いを投げれば答えが返る」という水準も含まれます。この水準を満たすツールをどう選ぶかは、本シリーズの後続記事で扱います
要件③の具体的な進め方は、別記事「データガバナンスとは?AI時代に求められる考え方と進め方」で解説しています。
6. 現実的な進め方|小さく始めて広げる
4つの要件を一度に満たそうとすると、前章の「対応③」と同じ結末になります。現実的には、次の順序で進めるのが定石です。
- ステップ①:領域を絞る。全社一斉ではなく、成果が見えやすい業務から着手します。判断の頻度が高く、効果を数字で示せる領域が適しています
- ステップ②:データを統合し、品質を整える。その領域に必要なデータだけを統合し、定義と品質を整えます。範囲が限定されているため、短期間で形になります
- ステップ③:現場が自分で使える状態にする。業務側が自分で参照し、問いを投げられる状態にします。ここを飛ばすと、依頼と順番待ちの構造が残ります
- ステップ④:成功事例をつくり、横展開する。「この判断がこう変わった」という事例を1つ作り、他部門へ広げます。社内を説得する材料は、成功事例が最も強いです
- ステップ⑤:定義と運用のルールを整備する。広がってから、指標の定義や更新のルールを整備します。最初から完璧な規程を作ろうとすると、着手が遅れます
7. Qlikによる解決|データを「使える状態」にする
ここまで挙げた要件に対して、Qlikの製品群がどう対応するのかを整理します。
データを統合し、品質を測る|Qlik Talend Cloud
多様なデータソースからの統合と、データ品質の評価・管理を一体で提供するプラットフォームです。第5章で挙げた要件①(統合)と要件③(品質)に対応します。品質をスコアとして可視化できるため、「この数字は信頼できるのか」という問いに根拠を持って答えられます。
鮮度を確保する|Qlik Replicate / Qlik Talend Cloud
データベースの変更をトランザクションログから捉えて反映するCDC(変更データキャプチャ)により、ニアリアルタイムでのデータ連携を実現します。夜間バッチでは追いつかない「鮮度」という論点、すなわち要件③の一部に対する答えです。このデータ連携の機能はQlik Talend Cloudにも統合されているため、統合・品質・鮮度を同じ基盤のなかで扱えます。
業務側が自分で答えを得る|Qlik Cloud AnalyticsとQlik Answers
要件④(誰でも使えること)に対応するのが、分析とAI活用を一体で提供するQlik Cloud Analyticsです。中核にあるのがQlik Analytical Engineで、あらかじめ定めた集計軸に縛られず、絞り込みに応じた集計をその場で返します。選択した条件に関連しないデータも把握できるため、見落としに気づけます。
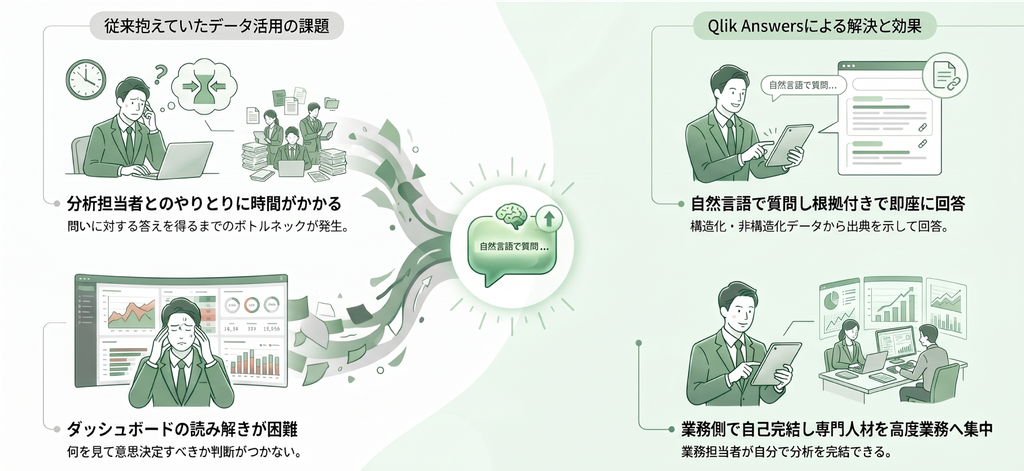
そのうえで本記事の文脈で特に重要なのが、Qlik Cloud上で提供される生成AI機能のQlik Answersです。自然言語で問いかけると、出典(根拠となった元データや文書)を示したうえで回答が返ってきます。構造化データと非構造化データの両方を対象にできる点も特徴です。
これは第3章に述べた「何をどう見ればよいかが定まっていない」という問題を解決します。「何を見れば意思決定できるのか分からない」「分析担当とのやりとりに時間がかかる」という状態に対して、業務側が自分の言葉で問いを投げ、根拠つきの答えを得られることで、ダッシュボードを読み解く作業ではなく、問いに答えが返る形に変わります。これまでデータ分析の専門人材が担ってきた役割の一部を、業務側が自分で完結できるようになるということです。結果として、分析人材はより専門性の高い領域に時間を使えます。
外部のAIアシスタントから使う|Qlik MCPサーバー
Qlikは、Model Context Protocol(MCP)に対応した外部連携機能(MCPサーバー)を提供しています。これにより、Qlikの外側にあるAIアシスタントから、Qlik上の分析機能とガバナンスされたデータへアクセスできます。社内で使っているAIアシスタントの画面から、そのままQlik上のデータに問いかけるという使い方が想定されます。
重要なのは、こうした外部連携を企業のガバナンスとリスク管理の枠内で行えるという点です。AIが社内データへアクセスする際の権限設計については、別記事「AIに社内のデータ・システムを安全につなぐには?MCPの仕組みと選び方」で解説しています。
導入して終わりにしない|伴走による支援
ここまでの製品は、導入すれば自動的に成果が出るものではありません。どの領域から着手するか、どの指標を見れば判断できるのか、業務側が自分で使える状態をどう作るのか——実際に日々の業務や運用を回すところに、最も手間がかかります。
インサイトテクノロジーでは、データベース技術の知見をもとに、データ基盤の設計・構築から、その先の「どう使うか」までを一貫してご支援しています。PoC(概念実証)で小さく試し、効果を確認してから広げるという進め方にも対応しています。
まとめ
- データドリブンはツールの導入状態ではなく組織の状態を指す。BIツールの導入や専門人材の採用だけでは進まない
- 本質は、誰もが必要なときに信頼できるデータを参照でき、かつ行いたい意思決定に対して適切な手法と結果が得られる状態をつくること
- 進まない要因は2層ある。データが使える状態にない(分断・定義の不一致・手間・鮮度・信頼)という5つと、何をどう見ればよいかが定まっていない(問いの立て方・指標の取り違え・分析担当とのやりとり)という3つ
- 必要な要件は、統合・意味の定義・品質・誰でも使えること の4つ。一度に満たそうとせず、領域を絞って着手し、成功事例をつくって広げる
- データ側はQlik Talend CloudまたはQlik Replicateで整え、使う側はQlik Cloud AnalyticsとQlik Answersで「問いに答えが返る」状態をつくる。外部のAIアシスタントからの利用はQlik MCPサーバーで統制を保ったまま実現できる
データドリブンの実現をご検討の方へ
「方針は決まったが、どこから手をつければよいか分からない」「データが散在していて横断的に見られない」「分析担当への依頼待ちが発生している」——インサイトテクノロジーでは、データ基盤の構築から、業務側が自分でデータを使える状態をつくるところまでを一貫してご支援しています。領域を絞ったPoCからのご相談も承ります。
▼ Qlik Talend Cloudについて詳しく見る
https://www.insight-tec.com/products/qlik-talend-cloud
▼ サッポロホールディングス様のQlik Talend Cloud活用事例を見る
https://www.insight-tec.com/case/sapporohd_0037
▼ 当社ご提供のPoCサービスについて詳しく見る
https://www.insight-tec.com/products/consulting/#sec1_0401
▼ データ活用・データ基盤の構築に関するご相談(PoCのご相談も承ります)
https://www.insight-tec.com/products/consulting/#f