Webサーバーは複数台で負荷分散している。アプリケーションサーバーも冗長化されている。では、その裏側にあるデータベースはどうなっているでしょうか。
可用性を高める取り組みは、まずアプリケーション層から進むのが一般的です。台数を増やせば対応できることが多く、構成も比較的単純だからです。一方でデータベースは、データという「状態」を持つため、単に台数を増やせば済むわけではありません。結果として、上位の層は二重化されているのにデータベースだけが1台のまま、という構成が残り続けます。
冗長化は「止まらないようにする」ための手段です。ただし、何から守るのかによって必要な構成は変わります。機器の故障なのか、データセンター全体の停止なのか、データそのものの破壊なのか。守りたい対象を決めないまま構成を決めると、「冗長化したのに止まった」という結果になりかねません。本記事では、冗長化の考え方と構成の種類を整理したうえで、データベース層で見落とされがちな論点を取り上げます。
この記事で分かること
- 冗長化・高可用性(HA)・可用性という言葉の関係と、冗長化では守れないもの
- アクティブ・スタンバイ、アクティブ・アクティブ、クラスタ構成、レプリケーションの違いと選び方
- データベースの冗長化でつまずきやすい5つの論点
1. 冗長化とは
定義と目的
冗長化とは、同じ機能を持つ構成要素を複数用意し、一方が停止してももう一方で処理を継続できるようにすることです。サーバー、ストレージ、ネットワーク機器、電源、回線など、あらゆる階層が対象になります。
目的は、単一障害点(SPOF:Single Point of Failure)をなくすことです。「そこが壊れると全部止まる」箇所を洗い出し、代替手段を用意していく作業であり、逆にいえば一箇所でも単一構成が残っていれば、他をどれだけ二重化してもその箇所でシステムは止まります。アプリケーション層を冗長化したあとにデータベースが残るのは、まさにこの状態です。
冗長化・高可用性・可用性の関係
可用性(Availability)は、システムが使える状態にある割合を指す結果の指標で、「稼働率99.9%」のように表現されます。高可用性(HA:High Availability)は、その可用性を高い水準で維持することを目指す考え方や、それを実現する構成の総称です。そして冗長化は、高可用性を実現するための手段のひとつです。
つまり「冗長化すれば高可用性になる」のではありません。HA構成として機能させるには、冗長化に加えて、障害の検知、切り替えの仕組み、切り替え後に業務が継続できる状態の確保までが必要になります。
冗長化しても守れないもの
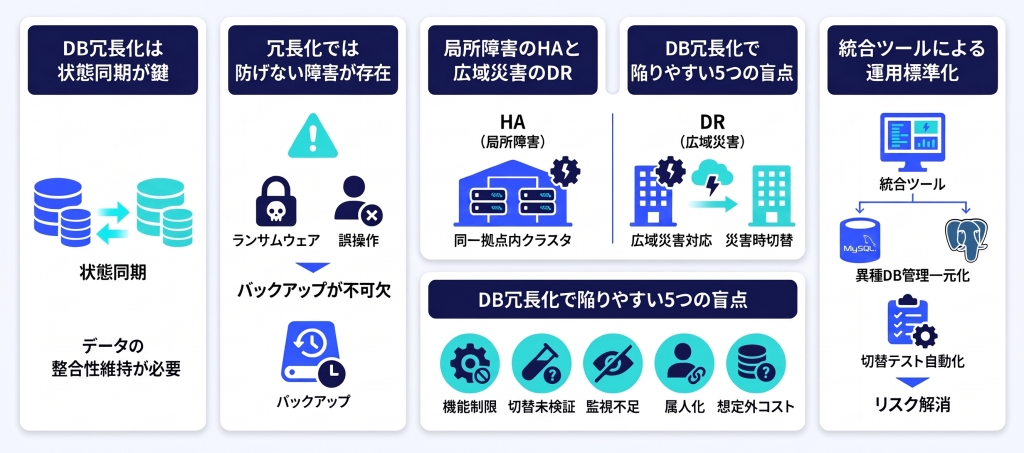
見落としやすいのが、冗長化の守備範囲です。冗長化が守るのは、あくまで「構成要素が壊れること」です。次のようなケースは、冗長化では守れません。
- オペレーションミスによるデータの削除や更新
- アプリケーションの不具合などによる論理的なデータ破損
- ランサムウェアによるデータの暗号化
いずれも、データの変更そのものは正しい処理として扱われるため、待機系やレプリカにもそのまま反映されます。同期が速い構成であればあるほど、誤った変更も速く伝わります。
これら3つに備えるのは、バックアップの役割です。バックアップは、ある時点のデータを別に保存しておき、誤った変更が起きる前の状態へ戻せるようにする仕組みです。冗長化が「壊れても止まらないようにする」ための手段であるのに対し、バックアップは「失われた状態を取り戻す」ための手段であり、目的が異なります。どちらかがあれば足りるという関係にはなく、両方を揃えて初めて守れる範囲が埋まります。また、ランサムウェア対策としての復旧の設計は、本シリーズの後続記事で扱います。
2. 冗長化構成の種類
では、データベースを冗長化するときに何ができるのか。それを判断するには、冗長化という手段にどんな型があるのかを先に押さえておく必要があります。選ぶ型によって、切り替えにかかる時間も、失われうるデータの量も、かかる費用も変わるためです。ここでは代表的な4つの型を整理します。
アクティブ・スタンバイ
稼働系(アクティブ)と待機系(スタンバイ)を用意し、障害時に待機系へ切り替える構成です。待機系をどこまで起動しておくかによって、さらに3つに分かれます。
- コールドスタンバイ:機器は用意してあるが、通常は停止している。切り替えに最も時間がかかるが、費用は抑えられる
- ウォームスタンバイ:OSやミドルウェアまでは起動しておき、障害時にアプリケーションやデータベースを起動する
- ホットスタンバイ:待機系も常時稼働し、データも同期されている。切り替えが最も速い
アクティブ・アクティブ
複数の系統が同時に処理を担う構成です。平常時から全系統が処理に参加しているため、1系統が停止しても切り替えという概念自体が最小限で済み、停止時間を短くできます。一方で、同じデータへの更新が複数系統から同時に発生するため、整合性の管理と設計の難易度は上がります。データベースでは、更新の競合をどう扱うかが設計の中心的な課題になります。
クラスタ構成
複数のサーバーを束ねて、外部からは一つのシステムとして見えるようにする構成です。クラスタ構成は大きく2つに分かれます。
- 共有ディスク型:複数のサーバーが同一のストレージを共有する。データは1か所にあるため整合性は保ちやすいが、そのストレージ自体が単一障害点になりうる。
- シェアードナッシング型:各サーバーがそれぞれのストレージを持ち、データを分散または複製する。ストレージの単一障害点をなくせるが、データの配置と整合性の設計が必要になる。
レプリケーション
データを別のサーバーへ複製し続ける方式です。物理レプリケーションは、データベースが出力するログ(Oracleのアーカイブログ、SQL Serverのトランザクションログなど)を転送して適用する方式で、複製先は元のデータベースとほぼ同一の状態になります。論理レプリケーションは、更新内容をSQLなどの論理的な単位で複製する方式で、バージョンや製品が異なる環境へも複製しやすい反面、対象を選べるぶん構成は複雑になります。拠点をまたぐ災害対策では、構成を単純に保ちやすい物理レプリケーションが使われることが多くなります。
4つの構成を比較する
| 比較軸 | アクティブ・スタンバイ | アクティブ・アクティブ | クラスタ構成 | レプリケーション |
| 切り替えにかかる時間 | 待機系の起動状態によって、分単位から時間単位まで幅がある | 切り替えという工程が最小限で済み、停止時間を短くしやすい | 秒から分単位 | 切り替え操作が必要で、分単位が目安 |
| データの欠損 | 同期方式と転送間隔によって変わる | 原則として欠損しない設計にできる | 共有ディスク型では欠損しにくい | 非同期転送の場合、未転送分が欠損しうる |
| 構築の難易度 | 比較的低い | 高い。整合性の設計が必要 | 中程度から高い | 中程度 |
| コスト | 待機系の起動状態に応じて変わる | 全系統が稼働するため高くなりやすい | 共有ストレージや専用製品が必要 | 待機系とネットワークの費用 |
| 距離の制約 | 構成によっては遠隔地にも配置できる | 距離が延びるほど遅延の影響を受ける | 同一拠点内が前提になりやすい | 遠隔地へ配置しやすい |
※ 実際の値は製品・構成・回線条件によって変わります。上表は方式ごとの傾向を整理したものです。
3. フェイルオーバーの仕組みと注意点
4つの構成はいずれも、待機系や別系統を「用意する」ところまでの話です。しかし冗長化が実際に役に立つのは、障害が起きて処理が引き継がれた瞬間です。構成があっても、その引き継ぎが期待どおりに成立するとは限りません。ここからは、稼働系から待機系へ役割を移す操作そのものを取り上げ、仕組みと、運用で問題になりやすい点を整理します。
フェイルオーバーとスイッチオーバーの違い
どちらも稼働系と待機系の役割を入れ替える操作ですが、前提が異なります。フェイルオーバーは障害が起きたあとに待機系へ役割を移すこと、スイッチオーバーは計画的に役割を入れ替えることです。
この違いは実務上重要です。計画的なスイッチオーバーであれば、更新を止めてから未転送分を送り切り、データを欠損させずに切り替えられます。一方、障害によるフェイルオーバーでは、転送が間に合わなかった分のデータが失われる可能性があります。同じ「切り替えられる構成」でも、どちらの経路で切り替わるかによって結果が変わります。
自動フェイルオーバーの難しさ
障害を検知したら自動で切り替わる構成は理想的に見えますが、運用に乗せるには注意が必要です。
- 誤検知:ネットワークの一時的な不通や高負荷を障害と判定し、健全な稼働系から切り替えてしまう。切り替え自体が障害になる
- スプリットブレイン:稼働系と待機系の間で通信ができなくなった結果、両方が自分を主系と認識して更新を受け付けてしまう状態。双方にそれぞれ別のデータが書き込まれ、復旧時にどちらを正とするかの判断が必要になる
このため、自動化する場合でも、検知条件や待機時間の設計、第三者からの監視を組み合わせるといった対策が前提になります。
フェイルバック(切り戻し)まで設計されているか
切り替えたあと、元の環境へ戻す手順も設計しておく必要があります。元の稼働系が復旧したとき、その間に待機系で発生した更新をどう反映するのか。再同期にどれだけ時間がかかるのか。この手順が決まっていないと、「切り替えはできたが、元に戻せないまま待機系で運用を続ける」という状態になります。
「切り替えられること」と「業務が動くこと」は別の問題
データベースの切り替えが完了しても、業務が再開できるとは限りません。アプリケーションの接続先が切り替わるか。接続文字列やDNSの切り替えが設計に含まれているか。バッチ処理や連携先のシステムが新しい環境を前提にできるか。アカウントや権限、ジョブ定義といったデータ以外の設定が待機系にも反映されているか。こうした確認は実際に切り替えてみなければ判明しません。だからこそ、構成を作ることと同じだけ切り替えのテストが重要になります。
4. 高可用性(HA)と災害対策(DR)は別物
守る対象が違う
HA(High Availability)とDR(Disaster Recovery)は、どちらも「止まらない・早く戻す」ための仕組みですが、守る対象が異なります。HAは同一拠点のなかで、サーバーやディスクの故障、プロセスの異常といった局所的な障害から守る仕組みで、切り替えは秒から分単位で完了することが前提です。一方DRは、拠点そのものが使えなくなった場合に別の拠点で業務を再開するための仕組みで、想定する事象はデータセンターの全停電、広域災害、拠点レベルのネットワーク断などです。
同一拠点のクラスタ構成だけでは災害に備えられない
同一拠点内のHA構成は機器単位の障害には有効ですが、その拠点ごと使えなくなる事象には対応できません。共有ディスク型のクラスタであれば、共有ストレージが被災した時点で待機系も使えません。「クラスタを組んでいるから災害対策もできている」という理解は、ここでずれが生じます。
なお、仮想化基盤側で監視・バックアップ・HA構成をどう設計するかについては、別記事「KVM環境の運用設計|監視・バックアップ・HA構成のポイント」で解説しています。
離れた拠点へ複製する場合の制約
DRとして別拠点へデータを複製する場合、距離に伴う制約が出てきます。
- 回線帯域:更新量に対して帯域が足りなければ、転送が追いつかず差分が溜まり続ける
- 遅延:距離が延びるほど往復の遅延が大きくなる。同期転送にすれば欠損は防げるが、本番の更新性能が遅延に引きずられる
- 転送方式の選択:同期転送はデータを失わない代わりに性能と可用性が回線に依存し、非同期転送は性能を保てる代わりに未転送分が失われうる
どこまでの停止とデータ欠損を許容するのかという目標値(RTO・RPO)の決め方は、本シリーズの後続記事で詳しく扱います。
5. データベースの冗長化で見落とされがちな論点
ここまでは一般的な冗長化の話ですが、データベース層には固有の検討事項があります。実務で押さえておきたい主な論点は次の5つです。
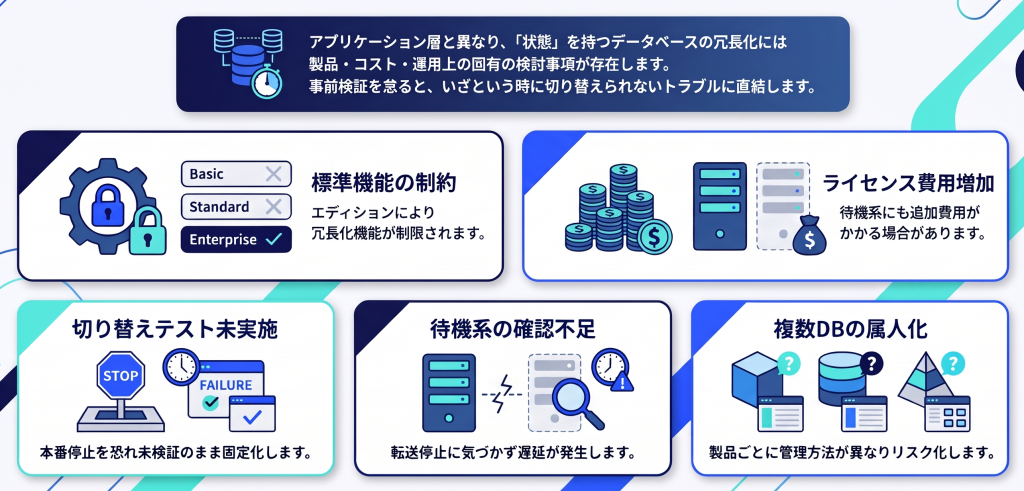
論点①:標準機能だけでは構成を組めない場合がある
アプリケーションサーバーは台数を増やせば冗長化できますが、データベースは製品やエディションによって使える機能が決まっています。たとえばOracle Databaseでは、スタンバイデータベースを構成・管理するData Guardの物理スタンバイはEnterprise Editionの機能であり、Standard Editionでは利用できません。Standard Editionにも「基本スタンバイ」と呼ばれる仕組みはありますが、ログの転送と適用、障害時の切り替えを自前の手順やスクリプトで作り込む必要があり、運用の負担が大きくなります。
「冗長化しましょう」という方針が決まったあとで、使っているエディションでは標準機能として組めないと判明する——この順番になりがちな点が厄介です。構成を検討する段階で、各製品が公開しているエディション別の機能差を確認しておく必要があります。
論点②:構成は作ったが、切り替えのテストが行われていない
DRやHAの構成を組んだあと、実際に切り替えを試したのはいつか。構築時の一度だけ、あるいは一度も実施していないという状態は珍しくありません。理由は単純で、テストのために本番を止められないからです。業務影響を伴うため調整のコストが高く、優先度が下がり続け、「構成はあるが切り替えられるかは分からない」状態が固定化します。切り替え後に業務が動くかどうかは試さなければ分かりません。テストしていない構成は、実質的に未検証の構成です。
論点③:待機系が最新の状態かを、日常的に確認していない
レプリケーションやログ転送による構成では、転送や適用が止まっていても稼働系は何事もなく動き続けます。待機系が数日前の状態で止まっていても、業務側からは気づけません。本番に影響が出ないため発見が遅れ、「いざ切り替えたら待機系が数日前のデータだった」という形で初めて判明します。遅延の監視と、異常時に通知が届く仕組みがあるかどうかは、構成そのものと同じくらい重要です。
論点④:複数のデータベースが混在し、運用が属人化する
基幹系はOracle、情報系はSQL Server、新規開発はPostgreSQL——時期ごとの判断が積み重なり、複数のデータベースが並存している環境は珍しくありません。問題は、冗長化の方式も、設定の方法も、監視すべき項目も、管理画面も、製品ごとに異なることです。それぞれに詳しい担当者が個別に運用する形になり、手順が人に紐づきます。担当者の異動や退職が、そのままDR構成の運用リスクになります。
論点⑤:冗長化した分だけ、ライセンス費用が増える
待機系を用意すればサーバー費用が増えるのは当然ですが、データベースのライセンス費用も確認が必要です。待機系にライセンスが必要になるか、必要な場合に稼働系と同等の費用がかかるかは、製品・エディション・待機系の起動状態・切り替えの頻度といった条件によって変わります。「待機系だから費用はかからない」と想定して構成を決めると、見積もりの段階で前提が崩れます。各ベンダーが公開しているライセンス条件を、構成を固める前に確認してください。
6. Dbvisit StandbyMPによる解決
ここまで挙げた論点のうち、エディションによる制約、切り替えテストの実施、待機系の状態把握、複数DBの運用統一は、ツールによって解きやすくなる部分です。インサイトテクノロジーが国内で提供している「Dbvisit StandbyMP」は、これらを対象にした製品です。
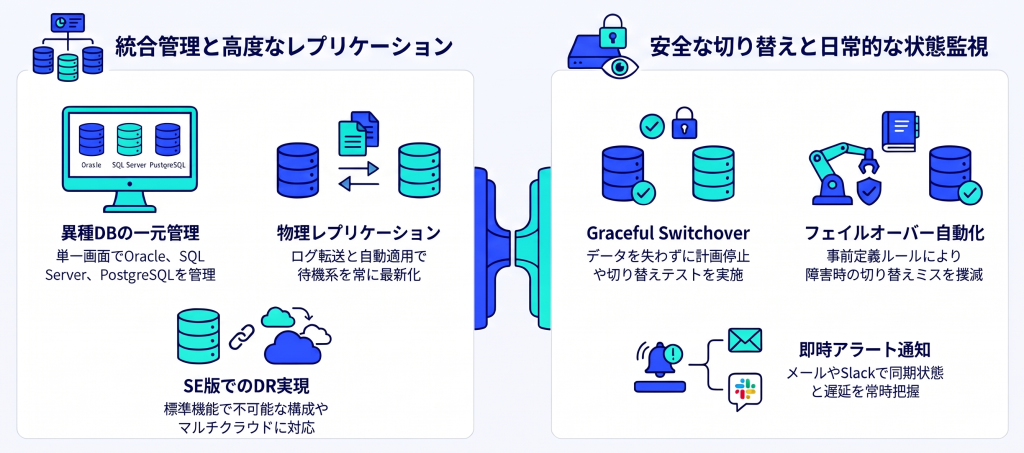
物理レプリケーションでスタンバイデータベースを維持する
稼働系が出力するアーカイブログを継続的に待機系へ転送し、適用し続けることでスタンバイデータベースを維持します。転送時の圧縮と暗号化に対応しており、暗号化は既定で有効です。複数のスタンバイを作成することもできます。
Oracle・SQL Server・PostgreSQLを同じ画面で管理する
Oracle(Enterprise Edition・Standard Edition・Express Edition)、SQL Server(Enterprise・Standard・Express)、PostgreSQLのDR構成を、日本語対応のブラウザベースの画面から作成・確認・管理できます。構成の作成はガイド付きのワークフローで進むため、製品ごとに手順を覚え直す必要がありません。製品ごとに管理画面や設定方法が異なり、運用が担当者に紐づいてしまうという問題は、ここで解きやすくなります。
Oracle Standard Editionでも災害対策構成を組める点は、エディションによっては標準機能だけでスタンバイを構成できない、という制約に対する直接的な答えになります。オンプレミスに加えて、Oracle Cloud、AWS EC2、Azure上の構成にも対応しています。
フェイルオーバーとGraceful Switchover
障害時のフェイルオーバーは、あらかじめ定義したルールに従った自動実行と手動の実行の両方に対応します。手順を都度組み立てる必要がないため、切り替え作業に伴うミスを減らせます。
もうひとつが、稼働系と待機系の役割を入れ替えるGraceful Switchover(およびスイッチバック)です。データを失わずに役割を交代できるため、計画停止やパッチ適用の際に待機系へ処理を移してから作業する、という進め方ができます。これは、構成は作ったものの切り替えテストが行われないままになる、という問題への答えにもなります。切り替えを「本番を止める特別な作業」ではなく、業務影響を抑えた運用手順として実施できるようになるためです。
監視と通知で、待機系の状態を日常的に把握する
稼働系と待機系の両方の状態を監視し、メールやSlackへ通知します。ハートビートによる同期状態の確認や、問題が起きたときだけ通知する設定も可能で、「待機系が最新かどうかを誰も見ていない」という状態を避けられます。また、スタンバイから読み取り専用のレポート参照や、開発・テスト用のスナップショットを作成する機能もあり、待機系を「障害時にしか使わない資産」にしないという観点でも検討材料になります。
Oracle・SQL Server・PostgreSQLそれぞれの事情を踏まえた災害対策の組み方は、本シリーズの後続記事で詳しく扱います。
まとめ
- 冗長化は単一障害点をなくす手段であり、高可用性(HA)を実現する要素のひとつ。冗長化だけでは、オペレーションミス・論理破損・ランサムウェアによる暗号化は防げない
- 構成の型はアクティブ・スタンバイ、アクティブ・アクティブ、クラスタ構成、レプリケーションの4つ。切り替え時間・データ欠損・難易度・コスト・距離の制約で性格が分かれる
- フェイルオーバー(障害時)とスイッチオーバー(計画的)では結果が変わる。自動化には誤検知とスプリットブレインへの対策が前提で、切り戻しの手順まで設計しておく
- HAは同一拠点内の局所的な障害、DRは拠点そのものの停止に備えるもの。同一拠点のクラスタ構成だけでは広域災害に対応できない
- データベース層の論点は、標準機能だけでは組めない場合がある/切り替えテストが行われていない/待機系が最新か確認していない/複数DB混在で属人化する/待機系のライセンス費用を確認していない、の5つ
データベースの冗長化を見直したい方へ
「アプリケーション層は冗長化したが、データベースだけ手つかずになっている」「構成はあるが切り替えを試せていない」「Oracle・SQL Server・PostgreSQLが混在して運用が属人化している」——インサイトテクノロジーでは、データベース技術の知見をもとに、可用性と災害対策の構成設計から実装・運用までをご支援しています。現在の構成でどこまで守れているかの確認からでもご相談いただけます。
▼ Dbvisit StandbyMPの資料をダウンロード
https://www.insight-tec.com/download/?product[]=dbvisit&download_type=all
▼ Dbvisit StandbyMPを試す(無料トライアルのお問い合わせ)
https://www.insight-tec.com/product-trial/dbvisit
▼ データベースの冗長化・災害対策のご相談はこちら
https://www.insight-tec.com/products/dbvisit/#f